Повышение осведомленности
Платформа Security Awareness • Учебный фишинг • Разработка курсов на заказ
CYBERINSPECT
Проверка и мониторинг контрагента на киберугрозы
CYBERID
Комплексная защита данных, репутации и цифровых активов топ-менеджмента
DRP-сервис
Защита бренда и обнаружение цифровых угроз • Облачный сервис
Защита бренда и репутации
SOC
Центр мониторинга и реагирования на инциденты ИБ
Мониторинг и реагирование
Сетевая защита
NGFW • VPN • Proxy NAC NTA Криптошлюзы и криптокоммутаторы
Защита устройств и серверов
EPP • EDR • XDR • Sandbox и AntiAPT
Защита доступа и учётных записей
MFA • PAM • IDM
Защита от утечек данных DLP
Защита от утечек и взломов
Аутсорсинг ИБ
vCISO • vDPO • vCompliance • vКИИ • Подписка на ИБ • Vulnerability mgmt
Безопасность разработки
Анализ угроз • Анализ кода • Внедрение и сертификация процессов
Безопасность ИИ
Оценка зрелости и рисков • LLMSecOps • Red Teaming LLM • ISO 42001
Социотехнический пентест
Оценка уровня осведомленности сотрудников правилами ИБ
Пентесты цифровых продуктов
Сайт • Веб-приложения • Мобильные приложения • Анализ исходного кода
Пентесты инфраструктуры
Внешний периметр • Внутренний периметр • Wi-Fi
Системы менеджмента ISO
Проектирование и внедрение: 27001, 27701, 22301, 20000, 42001
Требования Банка России
Комплаенс для банков • 716-П, 833-П, 850-П, 851-П, SWIFT CSCF, ГОСТ 57580
Защита АСУ ТП
Категорирование • Проектирование • Внедрение • Испытания
Защита ГИС
Оценка зрелости • Проектирование • Аттестация • СМЭВ
Защита объектов КИИ
Категорирование • Проектирование • Внедрение • Испытания
Персональные данные
Аудит 152-ФЗ • Моделирование угроз • ТЗ/ТП СЗПДн • Оценка эффективности
Аудит и оценка рисков
Аудит • Киберчекап • Стратегия ИБ • Оценка и управление рисками
Аудит и консалтинг
Получить консультацию
Оставьте ваши данные и мы с вами свяжемся!


07.11.2026
Признаки текста, сгенерированного ИИ: как распознать и проверить детекторами
Ещё до появления ИИ-агентов, способных работать в программных инструментах любого профиля, большие языковые модели могли только отправлять текст в ответ на запрос пользователя. По сей день это остаётся самым распространённым сценарием использования ИИ.
Максим Глущенко
Консультант отдела риск-менеджмента кибербезопасности Infosecurity
Проблематика сгенерированного контента
Генерировать аналитические записки, красивые деловые письма или даже целые регламенты само по себе не плохо. Созданный моделью текст могли вычитать и удостовериться в том, что изложенные в нём мысли соответствуют задумке автора запроса.
Тем не менее, вокруг ИИ-контента сформировано устойчивое предубеждение, и не безосновательно. Не заслуживающая доверия форма порождает сомнения к содержанию. «Точно ли изложенная в статье экспертиза экспертна?». Реакция аудитории или заинтересованных лиц в этом случае может быть непредсказуемой: обесценивание, обвинения в некомпетентности, репутационные проблемы.
Обычной предвзятостью к сгенерированному контенту риски не ограничиваются. «Пересказ» конфиденциальной информации в нейросетевой манере (например, в документе или протоколе) является опасным сигналом, что сведения утекли из безопасного контура.
Поэтому, даже если автор промпта отнёсся к работе совестливо — перепроверил содержание, а для обработки чувствительной информации использовал локальные модели, он не застрахован от этических рисков в свою сторону.
В этой статье мы проведём практическое упражнение, разберём классические признаки сгенерированного текста, а также рассмотрим детекторы ИИ-текста.
Практическое упражнение: проверьте интуицию
Ниже предоставлены типичные положения из абстрактного документа по управлению доступом. Одно из них рукописное, другое — сгенерировано ИИ по образу и подобию человеческого.
Попробуйте угадать: какое из них какое? Правильный ответ будет в конце статьи.
Перейдём к типичным маркерам ИИ-текста, которые я подчеркнул из собственной практики:
1. Злоупотребление списками. Если вы когда-либо общались с ИИ чат-ботами, то наверняка замечали их стремление структурировать информацию посредством маркированных списков.
2. Злоупотребление длинными тире. Ещё одна классика llm, однако по моим наблюдениям современные модели грешат с этим намного меньше, чем раньше. Вероятно, из-за грамотной настройки параметра repetition penalty (наказание за повтор), который уменьшает вероятность повторения ранее использованных конструкций.
3. Избегание тавтологий/повторений. Однако, благодаря repetition penalty ИИ будет стремиться использовать синонимы к словам, даже когда это не целесообразно, например, в документах или текстах, где требуется точность и однозначность.
4. К конструкции с отрицанием («это не … — это …» и подобные). Параллельные конструкции, включающие «не», «но» или «однако», такие как «Не только... но и...» или «Это не просто о..., это...», часто встречаются в сгенерированном контенте.
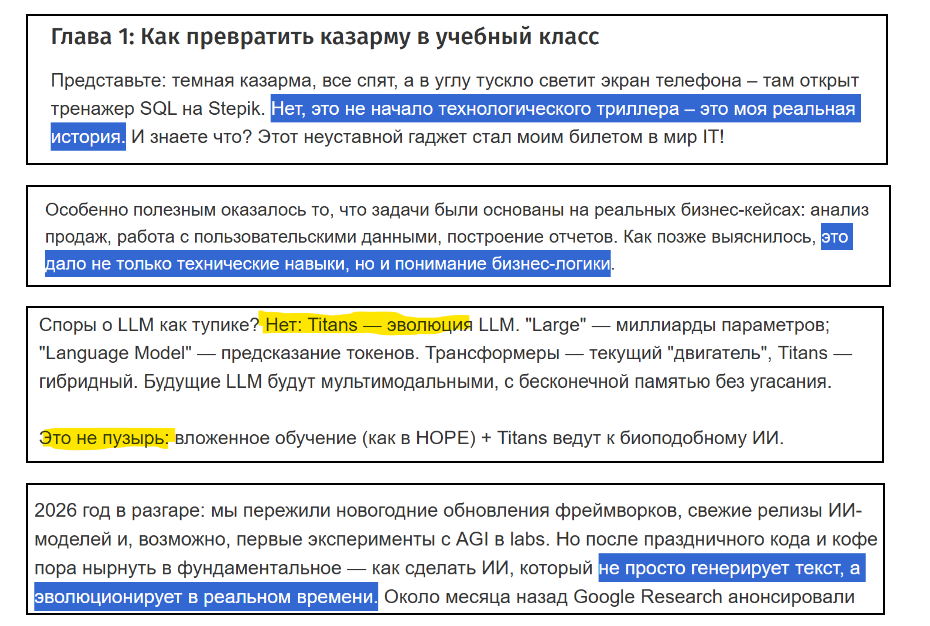
Один из признаков, который угадывается «на слух», благодаря чему можно узнать кто из ваших любимых блогеров или спикеров прибегает к ИИ в составлении сценариев.
5. Злоупотребление выделением. ИИ-чат-боты часто злоупотребляют жирным шрифтом или курсивом, выделяя текст бессмысленно. Эта привычка перенята из инструкций, рекламы и списков, где жирный шрифт используют часто.
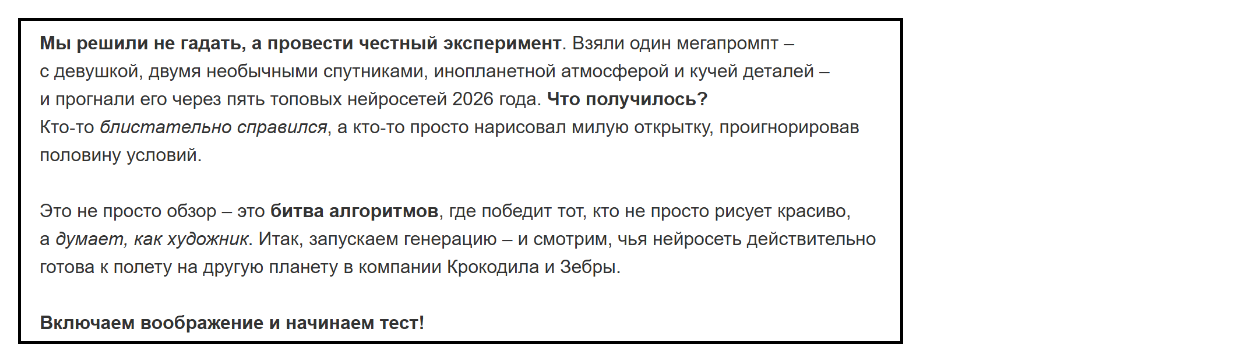
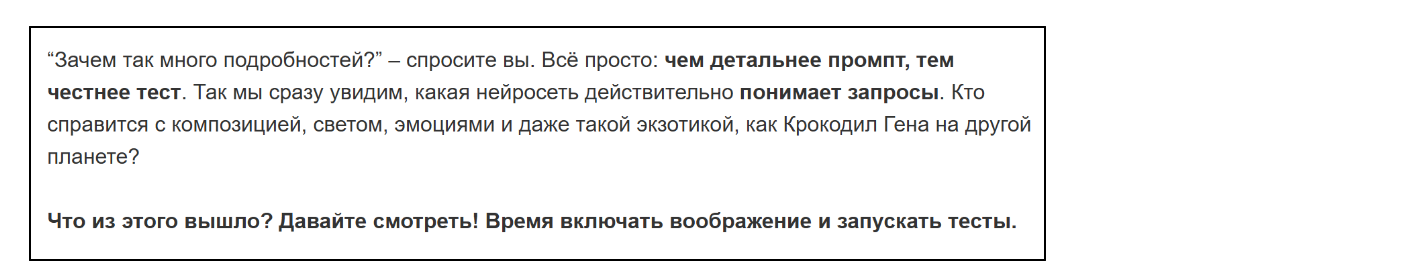
6. Прочие признаки на моей практике:
- Нарочито сложный, перегруженный язык (в контексте документов, отчетов и т.д.)
- Частые обобщения, упрощения, сравнения с «бытовыми примерами» (в контексте статей)
- Поверхностные выводы («В Компании используется “a”, что существенно уменьшает поверхность атаки…»
- Короткие абзацы (из одного-двух предложений). Часто встречается в любительской художественной литературе.
- Злоупотребление «правилом трёх»: («Это решение эффективно (1), масштабируемо (2) и трансформирует бизнес (3)»
Опционально, можете ознакомиться с другими признаками в эссе русскоязычной википедии:
Википедия: Признаки сгенерированности текста — Википедия
Википедия: Признаки сгенерированности текста — Википедия
Заключение: ответ на практическое упражнение + экспресс-обзор ИИ-детекторов
Сгенерированным был текст №1:
«Доступ к активам Компании предоставляется только после успешной аутентификации пользователя с использованием надежных методов (например, парольная аутентификация, усиленная двухфакторная аутентификация). Требования к сложности и периодичности смены паролей определяются отдельной инструкцией».
ИИ-детекторы не мыслят по-человечески, они работают с вероятностями, метриками предсказуемости текста, которыми по-прежнему можно манипулировать (например, через параметр температуры). А потому, даже сухая математика не даёт никаких гарантий.
Температура в LLM — это параметр, который контролирует степень случайности и креативности при генерации текста, делясь на диапазоны от 0 до 2.
Ещё одно ограничение детекторов, что они плохо работают с короткими текстами, и по-настоящему раскрываются на дистанции хотя бы более 500 символов. Любопытства ради, возьмём 5 детекторов ИИ-текста, которые выдаст нам поисковик и проверим их. Наши короткие положения из упражнения послужат серьёзным стресс-тестом.
По результатам эксперимента, правильно категорировал оба текста только детектор GigaCheck от Сбера. Разумеется, нашей выборки недостаточно, что уверенно определить лидера. Лучше положиться на независимые бенчмарки, если таковые существуют.
Заключение
Использовать ИИ не плохо по умолчанию. Ни один из маркеров или детекторов не гарантирует результат.
Умение распознавать типичные маркеры ИИ в тексте в наше время стало частью арсенала базовой цифровой гигиены. Но даже когда вы наострите глаз, навык должен дополнять общую картину: служить подтверждением изначального впечатления, сомнения или гипотез, а не превращаться в «охоту на ведьм».
FAQ: частые вопросы
▸Используете ли вы ИИ для написания статей?
Говорю за себя: конечно использую. Языковая модель помогает разгрузить сложный текст, подкрепить аргументы реальными кейсами, а также агрегировать статистику и мнения экспертов.
▸Может ли ИИ написать текст без перечисленных маркеров?
Да, достаточно просто уточнить в запросе каких конструкций стоит избегать, а некоторые признаки могут быть вовсе не свойственны для определённой модели.
▸Может ли человек написать текст как ИИ?
Да. Стоит держать в уме, что всё-таки LLM обучались на текстах, написанных людьми.
Читайте также:
Остались вопросы?
Оставьте свои контактные данные, чтобы мы могли связаться с вами для дальнейших шагов.
Информационная безопасность в финансовом секторе: новый подход к оценке и защите
Постановление № 92 от 06.02.2026: новые правила категорирования КИИ в банках, ежегодная отчётность, штрафы по ст. 13.12.2 КоАП и что делать банкам.
06.11.2026
Cookie и персональные данные: что нужно учитывать владельцам сайтов
Когда cookie считаются персональными данными, какие можно без согласия, что указать в cookie-баннере и почему мало политики конфиденциальности.
07.11.2026
Этапы подготовки к сертификации ISO/IEC 42001
Что такое ISO/IEC 42001 и как подготовиться к сертификации: структура стандарта, 5 этапов от обследования до аудита, цикл PDCA.
10.11.2026
10 шагов по внедрению ISO/IEC 27001
Пошаговый план внедрения ISO/IEC 27001 в 10 шагов: от области применения СУИБ до внутреннего аудита. Типовой срок подготовки — 5–12 месяцев.
05.11.2026
Другие статьи
Получайте новости из мира кибербезопасности, полезные материалы и специальные предложения для бизнеса. Отправляем только актуальную информацию — без лишних писем.
Оставайтесь на шаг впереди

Дайджесты
Акции
Чек-листы
Памятки
Новые услуги